Безопасность · Статья
Почему AI-агентам нужна песочница
Как изоляция, управляющий слой, проверки и участие человека превращают языковую модель в управляемую AI-систему.
AI-агент отличается от обычного чат-бота тем, что способен не только отвечать на вопросы, но и выполнять действия: искать информацию, запускать код, обращаться к базе данных, отправлять сообщения, изменять файлы и публиковать материалы. Чем больше у него инструментов, тем полезнее система — и тем выше цена ошибки.
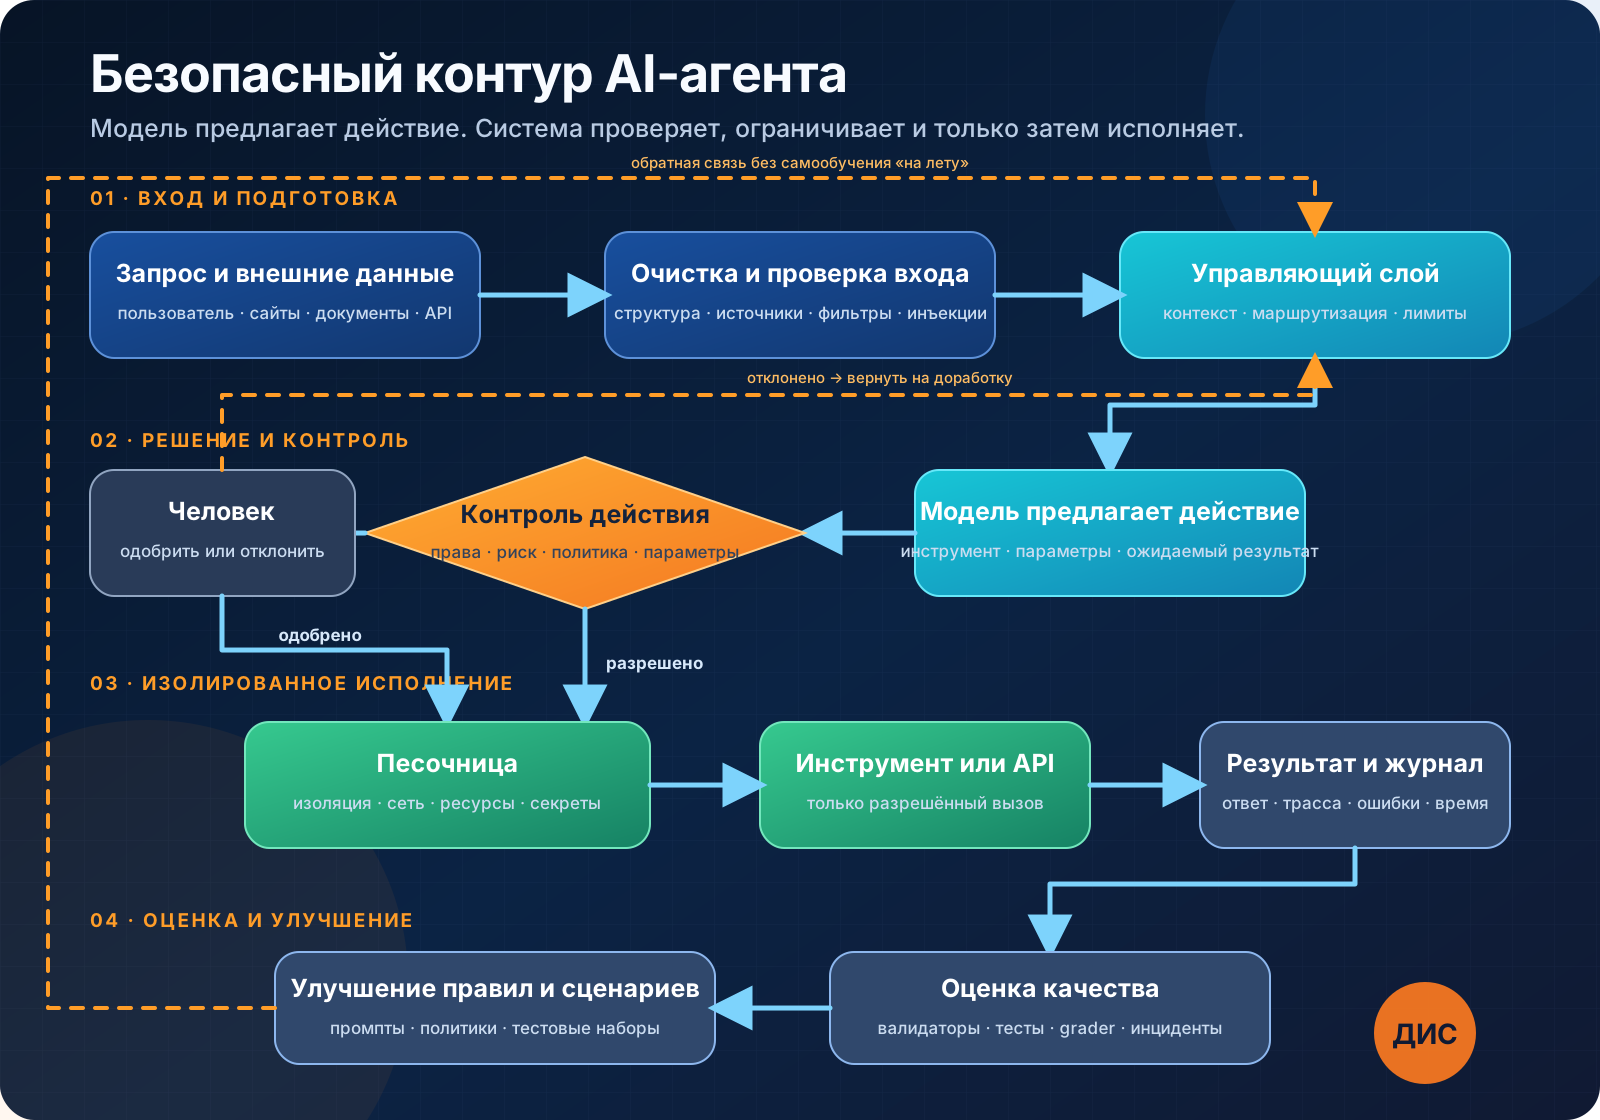
Современный AI-агент строится не как одна модель, получившая прямой доступ к внешним системам, а как управляемая цепочка. Модель предлагает действие и его параметры, управляющий слой проверяет запрос, изолированная среда запускает разрешённый инструмент, а отдельный модуль оценивает результат. Именно поэтому вокруг AI-агентов развивается самостоятельный класс технологий: песочницы, системы контроля инструментов, журналы действий и автоматические оценки.
Обезличенная схема безопасного AI-агента
Схема не привязана к конкретной компании, модели или программной платформе. Вместо названий продуктов в ней указаны функциональные роли компонентов. Её можно использовать как основу для контент-завода, медицинского ассистента, корпоративного агента или системы автоматизации.
Модель не должна выполнять команды напрямую
Языковая модель умеет рассуждать и выбирать следующий шаг, но её ответ нельзя считать готовой безопасной командой. Модель может неправильно понять запрос, выбрать неподходящий инструмент, сформировать ошибочные параметры или поддаться скрытой инструкции, найденной на внешнем сайте.
Поэтому между моделью и реальным действием нужен управляющий слой — agent harness, или исполнительный контур. Он получает предложенный вызов инструмента и решает:
- разрешено ли это действие;
- соответствует ли оно задаче пользователя;
- корректны ли параметры;
- какие данные можно передать инструменту;
- требуется ли подтверждение человека;
- где и с какими ограничениями выполнять команду.
Только после этих проверок вызов попадает в среду исполнения.
Что такое песочница
Песочница — это изолированная среда, в которой агент выполняет код или использует инструменты, не получая свободного доступа ко всей системе. Если команда окажется ошибочной, её последствия должны остаться внутри ограниченного контура.
В официальной документации OpenAI для агентных сред рекомендуются изоляция рабочих нагрузок, ограничение исходящего сетевого доступа и раздельное хранение учётных данных. Агенту следует открывать только необходимые файлы, сервисы и адреса, а долгоживущие секреты держать вне исполняемой среды. Это соответствует принципу минимальных привилегий: каждый компонент получает ровно тот доступ, который необходим для его задачи, и не больше. OpenAI: Sandbox security
На практике песочница может быть отдельным контейнером, виртуальной машиной или краткоживущей облачной средой. Важна не технология сама по себе, а границы:
- отдельная файловая система;
- лимиты времени, памяти и процессора;
- белый список сетевых адресов;
- отсутствие постоянных ключей внутри среды;
- запрет опасных системных команд;
- автоматическое удаление временных данных;
- полный журнал выполненных действий.
Откуда возникает риск
Одна из главных угроз — prompt injection. На странице, в документе или сообщении может находиться текст, который пытается выдать себя за инструкцию для агента: например, потребовать раскрыть данные, изменить настройки или отправить информацию на посторонний адрес. OpenAI относит такие внедрённые инструкции к распространённым и опасным атакам и рекомендует не позволять внешнему неструктурированному тексту напрямую управлять инструментами. OpenAI: Safety in building agents
OWASP дополнительно выделяет риски избыточной автономности, неправильной обработки результатов, раскрытия чувствительной информации и отравления данных. Это означает, что защищать необходимо не только входной запрос, но и весь путь от найденного материала до вызова внешнего инструмента. OWASP Top 10 for LLM Applications
Однако песочница не решает проблему полностью. Она ограничивает технические последствия, но не определяет, является ли действие правильным с точки зрения бизнеса, медицины или редакционной политики. Агент может выполнить допустимую команду не в тот момент, отправить корректный файл не тому получателю или опубликовать формально правильный, но недостоверный материал.
Поэтому над песочницей нужны дополнительные уровни контроля.
Пять уровней безопасного агентного контура
1. Проверка входных данных
Система отделяет запрос пользователя от данных, полученных из интернета, документов и внешних сервисов. Вход очищается, приводится к определённой структуре и проверяется на запрещённые инструкции, персональные данные и попытки изменить правила работы агента.
2. Ограниченный набор инструментов
Агент видит не всю инфраструктуру, а только специально подготовленные функции: найти материал, прочитать запись, создать черновик, отправить на согласование. Чем уже назначение инструмента, тем проще проверить его параметры и последствия.
3. Изолированное выполнение
Код, файлы и сетевые запросы обрабатываются в песочнице. Доступ к производственной базе, сайту и секретам выдаётся через отдельные контролируемые интерфейсы, а не напрямую.
4. Автоматическая оценка результата
После выполнения система проверяет, достигнута ли цель. Для этого используются валидаторы, тесты и grader — модуль оценки. Он может определить, выбрал ли агент правильный инструмент, соблюдал ли формат, использовал ли допустимые источники и нарушил ли правила безопасности.
OpenAI рекомендует анализировать трассы выполнения: последовательность обращений к модели, инструментам, защитным проверкам и другим агентам. Затем результат оценивается по формальным критериям. Такой подход помогает обнаруживать повторяющиеся ошибки и проверять, улучшили ли систему новые промпты или правила маршрутизации. OpenAI: Evaluate agent workflows
5. Подтверждение человека
Любое действие с заметными последствиями должно уметь останавливаться перед выполнением. Изменение данных, отправка сообщения, публикация, удаление файла или работа с чувствительной информацией требуют явного решения человека.
В документации OpenAI автоматические guardrails предлагается сочетать с human-in-the-loop: проверки валидируют вход, результат и вызовы инструментов, а чувствительная операция приостанавливается до одобрения или отклонения. OpenAI: Guardrails and human review
Проверка результата и обучение — не одно и то же
На схеме проверяющий модуль передаёт награду в контур обучения, после чего обновляются веса модели. Это типичный принцип обучения с подкреплением: система получает оценку за результат и использует её для улучшения поведения.
Но в рабочем приложении модель обычно не меняет свои веса после каждого пользовательского запроса. Сначала собираются трассы, ошибки и оценки. Затем разработчики анализируют их, уточняют промпты, инструменты и правила либо формируют отдельный проверенный набор данных для обучения. Такой разрыв между эксплуатацией и обучением защищает систему от случайного или намеренного «самообучения» на плохих примерах.
Для большинства прикладных проектов полезнее начать не с дополнительного обучения модели, а с более простого цикла:
запрос → действие в песочнице → проверка → решение человека → журнал → улучшение правил.
Такой подход согласуется и с практическими рекомендациями Anthropic: начинать с простых, прозрачных и составных решений, повышая автономность только там, где она даёт измеримую пользу. Для автономных агентов отдельно подчёркивается необходимость тестирования в изолированной среде и применения защитных ограничений. Anthropic: Building effective agents
Как применить этот подход в KnightCat
Для контент-завода KnightCat безопасный процесс может выглядеть так:
- Пользователь передаёт тему.
- Система собирает материалы из разрешённых источников.
- Внешний текст очищается от служебных и подозрительных инструкций.
- Модель готовит структурированный черновик и изображение.
- Валидатор проверяет JSON, ссылки, длину, дубли и обязательные поля.
- Отдельный модуль оценивает качество и надёжность источников.
- Черновик отправляется Дмитрию Степанову на согласование.
- Только после подтверждения выполняется публикация в Telegram и на st8dom.ru.
Таким образом, существующее в KnightCat человеческое подтверждение — не временное ограничение, а правильный элемент промышленной архитектуры. Следующий шаг — дополнить его очисткой входящих материалов, автоматическими проверками и журналом решений.
Особое значение для медицинского контента
В медицинских проектах недостаточно проверить только техническую корректность. Система должна отдельно оценивать происхождение информации, дату публикации, тип источника, соответствие клиническим рекомендациям и наличие противопоказаний.
Для Vitalis Medical AI и медицинского раздела портала целесообразно разделить контроль на два независимых контура:
- технический: формат, доступы, безопасность, отсутствие утечки данных;
- медицинский: первоисточник, актуальность, уровень доказательности, корректность формулировок и обязательное одобрение специалиста.
AI может найти источник, сопоставить документы и подготовить черновик, но решение о медицинской публикации должно оставаться за человеком. Такой подход соответствует общей логике управления рисками: риски необходимо выявлять, оценивать, контролировать и отслеживать на протяжении всего жизненного цикла системы. NIST AI Risk Management Framework
Практический минимум для небольшого проекта
Чтобы внедрить эту архитектуру, необязательно сразу строить сложную платформу. Для первого рабочего контура достаточно:
- запускать обработку в отдельном Docker-контейнере;
- передавать секреты через менеджер секретов или прокси;
- разрешать соединения только с нужными API;
- принимать от модели валидируемый JSON;
- проверять каждый вызов инструмента;
- сохранять журнал запросов, действий и ошибок;
- поставить ручное подтверждение перед публикацией и изменением данных;
- подготовить набор тестовых сценариев, включая ошибочные и вредоносные входы.
После этого можно добавлять автоматические grader-модули, сравнение версий промптов, мониторинг качества и повторяемые eval-тесты.
Вывод
Современный AI-агент — это не одна языковая модель. Это система из модели, управляющего слоя, инструментов, песочницы, проверок, журналирования и человеческого контроля.
Песочница отвечает на вопрос: «Где и с какими ограничениями агент может действовать?» Guardrails отвечают на вопрос: «Разрешено ли это действие?» Оценки показывают: «Насколько хорошо выполнена задача?» Человек принимает окончательное решение там, где ошибка может повлиять на данные, деньги, репутацию или здоровье.
Именно такая архитектура превращает эффектную демонстрацию AI в управляемый и пригодный для реальной работы продукт.
Источники
- OpenAI. Agents: архитектура и инструменты агентных систем
- OpenAI. Sandbox security: изоляция, сеть и защита учётных данных
- OpenAI. Safety in building agents: prompt injection и безопасная работа с инструментами
- OpenAI. Guardrails and human review
- OpenAI. Evaluate agent workflows: трассы, graders и eval-тесты
- Anthropic. Building effective agents
- OWASP. Top 10 for Large Language Model Applications
- NIST. Artificial Intelligence Risk Management Framework 1.0
- NIST. Generative Artificial Intelligence Profile, NIST AI 600-1
- MITRE. ATLAS: тактики и техники атак на AI-системы
- UK AI Security Institute. Incident report on unsanctioned agent behaviour
- ISO. ISO/IEC 42001:2023 — AI management systems
- European Commission. AI Act: risk-based approach and human oversight
Обновление: Материал и источники проверены 21 сентября 2026 года.